ChatGPT چرا یک صفحه را استناد می کند و صفحه دیگر را نه؟ بر اساس بررسی ۱.۴ میلیون پرامپت، صفحه ای شانس بیشتری دارد که از ایندکس جستجوی عمومی آمده باشد و عنوان و URL آن از نظر معنایی با پرسش های فرعی (Fanout Queries) خود ChatGPT هم خوانی داشته باشد.
ChatGPT فقط حدود ۵۰ درصد از URLهایی را که بازیابی می کند استناد می دهد. این نتیجه برای فعالان سئو و هوش مصنوعی اهمیت مستقیم دارد: رتبه گرفتن در نتایج جستجو شرط لازم است، اما کافی نیست.
خلاصه یافته ها
- ۸۸ درصد URLهای استناد شده مستقیم از ایندکس جستجوی عمومی (search) می آیند. پس برای استناد شدن باید رتبه بگیرید.
- ۶۷.۸ درصد URLهای استناد نشده از Reddit هستند. ChatGPT از Reddit یاد می گیرد، اما تقریباً هرگز آن را استناد نمی کند.
- شباهت معنایی عنوان صفحه با پرسش های فرعی ChatGPT، عامل مهمی در استناد است. اسلاگ به زبان طبیعی هم نرخ استناد را بالاتر می برد.
- سن میانه صفحه های استناد شده حدود ۵۰۰ روز است. تازگی فقط در حوزه خبر برتری روشنی ایجاد می کند.
ChatGPT چند درصد از URLهای بازیابی شده را استناد می کند؟
همه ما به لینک های آبی شماره دار کوچک در پاسخ های ChatGPT عادت کرده ایم. این ها استنادهایی هستند که پاسخ های ChatGPT را با اطلاعات بیرونی پشتیبانی می کنند.
اما با اینکه ChatGPT برای پاسخ به یک پرسش ده ها URL بازیابی می کند، طبق پژوهش ما فقط حدود ۵۰ درصد آن ها را استناد می دهد.
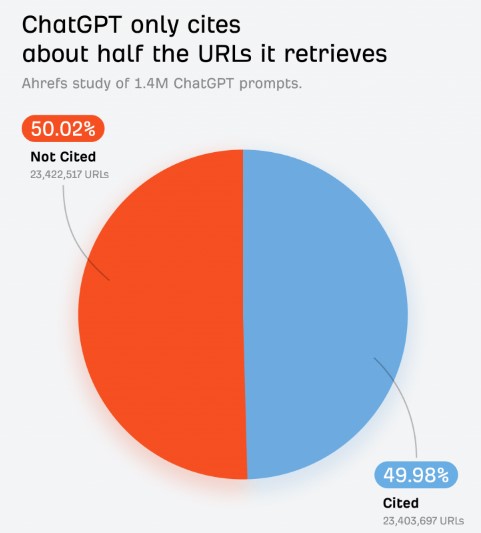
ChatGPT فقط حدود ۵۰ درصد از URLهایی را که برای پاسخ بازیابی می کند استناد می دهد. صفحه ای که از ایندکس جستجوی عمومی بیاید و عنوان و URL آن از نظر معنایی با پرسش های فرعی ChatGPT هم خوان باشد، شانس بیشتری دارد. ۸۸ درصد استنادها مستقیم از جستجوی عمومی گرفته می شوند.
چرا یک صفحه اعتبار می گیرد و صفحه دیگری که هوش مصنوعی آن را هم بازیابی کرده، هیچ چیزی نمی گیرد؟
ChatGPT پیش از باز کردن صفحه چه چیزی را می بیند؟
طبق مطالعات دن پتروویچ (Dan Petrovic)، متخصص هوش مصنوعی، وقتی ChatGPT نتایج را بازیابی می کند، هر نتیجه با عنوان صفحه، یک اسنیپت (Snippet) یا خلاصه کوتاه، URL و یک شماره شناسه برمی گردد.
ChatGPT با این داده ها تصمیم می گیرد کدام صفحه ها ارزش باز کردن و در نهایت استناد شدن در پاسخ را دارند.
به بیان دیگر، پیش از آنکه ChatGPT محتوای واقعی صفحه شما را باز کند و بخواند، یک لایه دروازه بانی وجود دارد. عنوان، اسنیپت و URL در این تصمیم اولیه بیشترین بار را به دوش می کشند.
نکته جانبیURLهای این مطالعه به عنوان بخشی از فرایند بازیابی ChatGPT برگردانده شده اند؛ اما این لزوماً به این معنا نیست که همه آن ها به طور کامل باز و خوانده شده اند.
بر اساس پژوهش های بیرونی درباره این فرایند، ChatGPT پیش از تصمیم برای باز کردن صفحه ها، نامزدها را با داده های بازیابی همراه هر نتیجه (عنوان، URL، اسنیپت و غیره) ارزیابی می کند.
احتمالاً بعضی URLهای استناد نشده اصلاً باز نشده اند. عدد ۵۰ درصد ما کل مسیر از بازیابی تا استناد را در بر می گیرد، نه فقط تصمیم نهایی پس از خوانده شدن صفحه.
این مطالعه چه چیزی را بررسی کرد؟
در این مطالعه می خواستیم بدانیم واقعاً چه چیزی روی استناد اثر می گذارد. آیا شباهت معنایی بیشتر بین داده های بازیابی یک صفحه و پرسش کاربر، احتمال استناد را بالا می برد؟ کدام فیلدها مهم ترند؟ آیا URLهای قابل خواندن برای انسان بهتر از URLهای مبهم عمل می کنند؟
برای پاسخ، با کمک شی بی جیا گوان، دانشمند داده Ahrefs، ۱.۴ میلیون پرامپت ChatGPT 5.2 مربوط به فوریه ۲۰۲۵ (نسخه دسکتاپ) را تحلیل کردیم.
اما پیش از رفتن سراغ یافته ها باید بدانید ChatGPT دقیقاً چطور منابعش را جمع می کند، چون همه URLها از یک مسیر وارد سیستم نمی شوند.
همه منابع یک اعتبار ندارند: سلسله مراتب ref_type
وقتی ChatGPT نتایج را بازیابی می کند، منابع را با یک فیلد داخلی به نام ref_type دسته بندی می کند. این فیلد در اصل برچسب کانال بازیابی است که URL از آن وارد شده.
ما پنج دسته پیدا کردیم: search، news، reddit، youtube و academia.
نرخ استناد بین این دسته ها به شدت نابرابر است:
| ref_type | درصد استناد | تعداد کل داده ها |
|---|---|---|
| search | ۸۸.۴۶٪ | ۲۵,۵۶۳,۵۸۹ |
| news | ۱۲.۰۱٪ | ۳,۹۴۰,۵۳۷ |
| ۱.۹۳٪ | ۱۶,۱۸۲,۹۷۶ | |
| youtube | ۰.۵۱٪ | ۹۵۳,۶۹۳ |
| academia | ۰.۴۰٪ | ۱۸۵,۳۳۷ |
ایندکس جستجوی عمومی (search) هم از نظر حجم و هم از نظر نرخ استناد برتری دارد. ۸۸ درصد URLهایی که ChatGPT در نهایت استناد می کند، مستقیم از جستجو گرفته شده اند.
اگر می خواهید ChatGPT شما را استناد کند، باید در این مجموعه انتخاب جستجو حضور داشته باشید، یعنی محتوایتان باید رتبه بگیرد.
این موضوع تازه ای نیست. تا الان بیشتر مردم می دانند رتبه نقش دارد، اما خوب است داده های بیشتری آن را تأیید کنند.
در مقابل، حوزه های تخصصی مانند YouTube (مثلاً youtube.com) و آکادمیک (مثلاً arXiv.org) به مقدار زیاد وارد می شوند، اما تقریباً هرگز به عنوان استناد واقعی نمایش داده نمی شوند.
نکته جانبیref_type با نام «search» نتایج Reddit و YouTube را هم شامل می شود. هر صفحه Reddit یا YouTube که از طریق جستجوی وب استاندارد برگردد، در آنجا دیده می شود.
ref_typeهای جداگانه «Reddit» و «YouTube» احتمالاً نتایج اضافی را نشان می دهند، یعنی نتایجی که از طریق یکپارچگی های API اختصاصی وارد شده اند، علاوه بر هر چیزی که جستجوی وب قبلاً برگردانده بود.
به همین دلیل حجم این کانال ها این قدر زیاد است؛ ChatGPT نتایج جستجویش را با یک فید جداگانه از محتوای Reddit و YouTube تکمیل می کند.
این موضوع برای تفسیر بقیه تحلیل بسیار مهم است.
ChatGPT به طور میانگین در هر پرامپت حدود ۱۶.۵۷ URL استناد شده و حدود ۱۶.۵۸ URL استناد نشده بازیابی می کند.
اما چون Reddit ۶۷.۸ درصد مجموعه استناد نشده ها را تشکیل می دهد، هر مقایسه کلی «استناد شده در برابر استناد نشده» در واقع مقایسه نتایج جستجو با خروجی API ردیت است. این مقایسه، سیب با سیب نیست.
به همین دلیل در سراسر این پژوهش، هر جا ممکن بود تحلیل را بر اساس ref_type جدا کردیم تا این تحریف پیش نیاید.
چرا ۶۷.۸ درصد URLهای استناد نشده از Reddit هستند؟
این احتمالاً چشمگیرترین یافته در مجموعه داده است.
Reddit در سیستم بازیابی ChatGPT ref_type اختصاصی خودش را دارد و در داده های ما بیش از ۱۶ میلیون نقطه داده دارد.
با این حال، نرخ استنادش فقط ۱.۹۳ درصد است.
در همین حال، ۶۷.۸ درصد همه URLهای استناد نشده از Reddit می آیند.
به عبارت دیگر: ChatGPT برای فهمیدن موضوعات، سنجیدن اجماع و ساختن زمینه، از Reddit زیاد استفاده می کند، اما تقریباً هرگز اعتبارش را به Reddit نمی دهد.
از جمع یاد می گیرد، بعد یک نهاد دیگر را استناد می کند.
صفحه های استناد نشده ۳ برابر داده بازیابی بیشتری دارند، اما ماجرا این نیست
همان طور که مختصر گفتیم، وقتی ChatGPT نتایج جستجو را بازیابی می کند، هر نتیجه با مجموعه ای از فیلدها برمی گردد؛ از جمله عنوان، URL و گاهی یک اسنیپت، یعنی گزیده کوتاهی از محتوای صفحه که در داده های بازیابی ChatGPT ذخیره می شود.
انتظار داشتیم پر بودن این فیلدهای بیشتر با نرخ استناد بالاتر همبستگی داشته باشد.
در نگاه اول، داده های کلی داستان دیگری می گفتند: صفحه های استناد نشده در داده های بازیابی ChatGPT در واقع فیلد پرشده بیشتری از صفحه های استناد شده داشتند.
URLهای استناد نشده ۱۴.۸۱ درصد مواقع اسنیپت داشتند، در برابر ۴.۳۶ درصد برای URLهای استناد شده، و احتمال داشتن تاریخ انتشار در آن ها بسیار بیشتر بود (۹۲.۷۲ درصد در برابر ۳۵.۹۸ درصد).
نزدیک بود همین را به عنوان یافته منتشر کنیم، اما خوشحالم که این کار را نکردیم.
وقتی عمیق تر شدیم، معلوم شد این اختلاف تقریباً به طور کامل یک پدیده ترکیبی (Compositional Artifact) است که از Reddit و سازوکار فرایند بازیابی ChatGPT ناشی می شود.
چون مجموعه استناد نشده ها عمدتاً Reddit است (۶۷.۸ درصد) و محتوای Reddit که از طریق API گرفته می شود طبیعتاً فراداده pub_date دارد، عدد ۹۲.۷۲ درصد یک پدیده ردیتی است، نه نشانه ای از اینکه ChatGPT صفحه های وب را به طور کلی چگونه ارزیابی می کند.
شکاف اسنیپت به شکل دیگری توضیح داده می شود. طبق پژوهش دیوید مک سوینی (David McSweeney) درباره فرایند بازیابی ChatGPT، مدل وقتی تصمیم می گیرد URLی را استناد کند، فیلد اسنیپت (گزیده کوتاه محتوا) را رها می کند و به جایش کل صفحه را باز می کند.
پس مسئله این نیست که ChatGPT صفحه های بدون اسنیپت را ترجیح می دهد. درصد پایین اسنیپت برای صفحه های استناد شده احتمالاً محصول جانبی نحوه کار فرایند است.
وقتی داده ها را فقط به ref_type «search» محدود کردیم و Reddit، news، YouTube و بقیه را کنار گذاشتیم، تصویر خیلی روشن تر شد:
| search | دارای اسنیپت | دارای pub_date | تعداد کل URLها |
|---|---|---|---|
| استناد شده | ۲.۵۲٪ | ۳۳.۷۹٪ | ۲۲,۶۱۲,۵۲۹ |
| استناد نشده | ۰.۰۹٪ | ۴۹.۰۰٪ | ۲,۹۵۱,۰۶۰ |
داده اسنیپت در هر دو گروه داخل حوزه جستجو عملاً وجود ندارد؛ پس سیگنال قابل استفاده ای نیست. درصدهای تاریخ انتشار به هم نزدیک ترند، اما صفحه های جستجوی استناد نشده هنوز کمی بیشتر از صفحه های استناد شده pub_date دارند (۴۹ درصد در برابر ۳۳.۷۹ درصد).
به نظر می رسد تفاوت هایی که ابتدا بین URLهای استناد شده و استناد نشده دیدیم، به خاطر ترکیب داده ها و سازوکار بازیابی تحریف شده بودند. هر سیگنالی، اگر وجود داشته باشد، زیر نویز دفن شده است.
نتیجه صادقانه این است: از این داده ها نمی توانیم نتیجه قوی بگیریم که فیلدهای اسنیپت یا تاریخ انتشار نقش معناداری در استناد دارند یا نه.
شایان ذکر است که این مشکل احتمالاً درباره مطالعه های استناد دیگر هم صدق می کند. هر پژوهشی که URLهای «استناد شده» و «استناد نشده» را بدون در نظر گرفتن منشأ آن ها مقایسه کند، خطر دارد ویژگی های عجیب داده را با الگوهای واقعی اشتباه بگیرد.
چرا عنوان ها باید از نظر معنایی با پرسش های فرعی مرتبط باشند؟
برای اینکه ChatGPT بفهمد چه چیزی «قابل استناد» است، ارتباط را برآورد می کند؛ فرایندی که گاهی «امتیازدهی معنایی» (Semantic Scoring) نامیده می شود و قضاوت می کند مقاله و پرسش به هم مرتبط اند یا نه.
چون ChatGPT مدلی با کد بسته است، دید دقیقی از اینکه ارتباط را در درون چگونه تعیین می کند نداریم.
پس در این مطالعه از شباهت کسینوسی (Cosine Similarity) استفاده کردیم که از امبدینگ های (Embeddings) مدل های متن باز محاسبه می شود، تا کار ChatGPT را کمی و تقریب بزنیم.
ChatGPT URLها را با «پرسش های فرعی» (Fanout Queries) خودش تطبیق می دهد؛ یعنی زیرپرسش هایی که از پرامپت اولیه کاربر در درون تولید می کند تا واقعیت های مشخص را شکار کند.
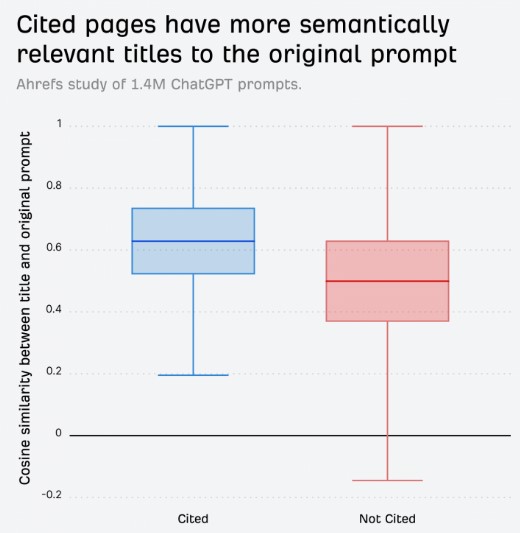
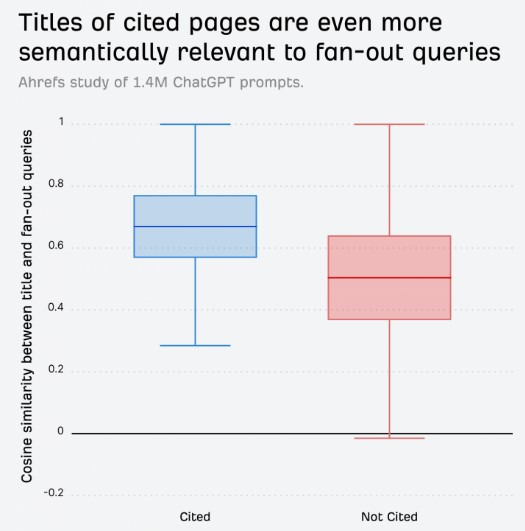
داده ها تأیید می کنند ارتباط عنوان با پرسش های فرعی، عامل مهمی در استناد است:
- پرامپت در برابر عنوان URL استناد شده: ۰.۶۰۲
- پرامپت در برابر عنوان URL استناد نشده: ۰.۴۸۴
- پرسش فرعی در برابر عنوان URL استناد شده (بیشترین تطابق*): ۰.۶۵۶
نکته جانبیبرای هر یک از این پرسش های فرعی، شباهت کسینوسی آن را با عنوان مقاله محاسبه می کنیم. امتیاز «بیشترین تطابق» بالاترین شباهت بین آن هاست؛ مثلاً اگر امتیازها ۰.۴۵، ۰.۷۱ و ۰.۳۸ باشند، بیشترین تطابق ۰.۷۱ است. این روش هم راستاترین زیرپرسش را می گیرد، نه میانگین همه تفسیرها که سیگنال را رقیق می کند.
نمودارهای جعبه ای (Box Plot) داستان را روشن نشان می دهند. در همه ref_typeها، URLهای استناد شده به طور پیوسته شباهت بیشتری بین عنوان خود و پرامپت اصلی دارند:
وقتی به جای پرامپت اصلی با پرسش های فرعی مقایسه می کنیم، شکاف بیشتر می شود. این نشان می دهد ساختن محتوای مرتبط با زیرپرسش های درونی ChatGPT چیزی است که واقعاً انتخاب را تعیین می کند:
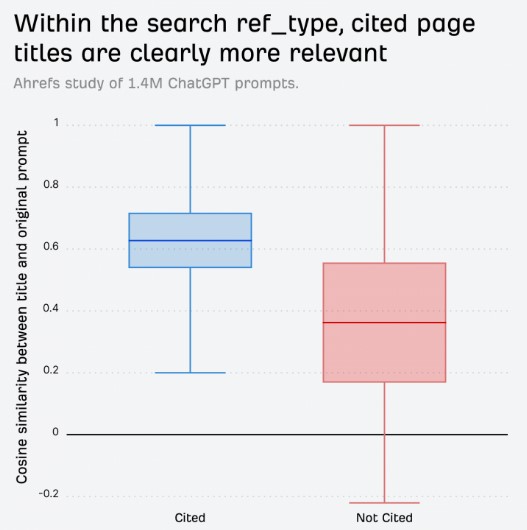
وقتی فقط ref_type برابر search را جدا می کنیم، الگو حتی واضح تر می شود. صفحه های استناد شده روشن است که مرتبط ترند و توزیع استناد نشده ها به طور چشمگیری پایین می آید:
همچنین دیدیم نتایج جستجو با اسلاگ (Slug) URL به زبان طبیعی نرخ استناد ۸۹.۷۸ درصد داشتند، در برابر ۸۱.۱۱ درصد برای نتایج بدون آن.
در نهایت، اگر URL و عنوان شما از نظر معنایی با پرسش های فرعی درونی هوش مصنوعی هم راستا نباشد، احتمال استناد شدنتان کمتر است.
سن میانگین صفحه استناد شده ۵۰۰ روز است (و باز هم انتخاب می شود)
این دانش رایج است که محتوای تازه تر بیشتر توسط هوش مصنوعی استناد می شود. در واقع مطالعه خودمان روی ۱۷ میلیون استناد هم این را تأیید می کند. دیدیم ChatGPT URLهایی را استناد می کند که ۴۵۸ روز از نتایج ارگانیک گوگل جدیدتر بودند؛ قوی ترین ترجیح تازگی بین همه پلتفرم هایی که بررسی کردیم.
این مطالعه آن روایت را نقض نمی کند، اما یک لایه ظرافت اضافه می کند.
مثلاً وقتی به ایندکس جستجو نگاه می کنیم، صفحه های استناد شده بازه سنی گسترده ای دارند: میانه حدود ۵۰۰ روز (حدود ۱.۳ سال) است و بعضی صفحه های استناد شده بیش از ۲,۷۰۰ روز (حدود ۷.۴ سال) قدمت دارند.
میانه سنی در واقع بسیار پایین تر از مطالعه تازگی اولیه ما (که در بالا لینک شده) است: ۹۵۸ روز در ژوئیه در برابر ۵۰۰ روز در این مجموعه داده. این نشان می دهد ChatGPT در ترجیح استنادش حتی جوان تر هم شده است.
با این حال، دیدیم صفحه های استناد نشده به طور غالب بسیار جوان هستند.
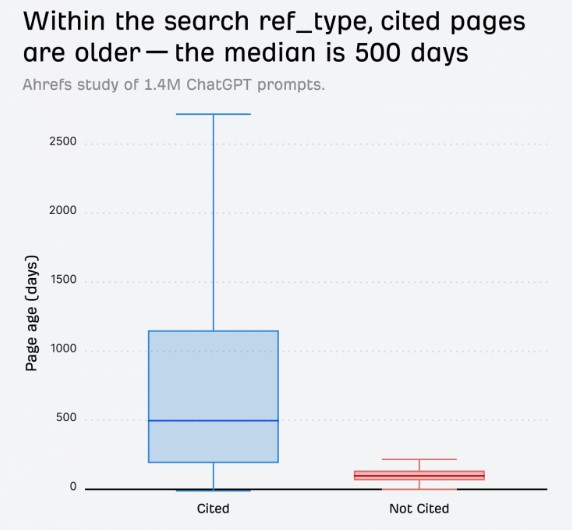
پس در مجموعه بازیابی یک پرامپت، این صفحه های قدیمی تر و جاافتاده تر هستند که استناد می شوند و تازه ترین محتوا معمولاً دور ریخته می شود.
به بیان دیگر، ChatGPT محتوای تازه را ترجیح می دهد، اما معمولاً محتوای نسبتاً «قدیمی تر» را بیشتر استناد می کند. این متناقض به نظر می رسد، اما هر دو می توانند هم زمان درست باشند.
در جمعیت گسترده تر استنادهای هوش مصنوعی، ChatGPT در مقایسه با نتایج گوگل و حتی در مقایسه با ترجیح استنادی خودش در سال گذشته، به سمت تازگی بیشتر متمایل است.
اما درون یک مجموعه بازیابی مشخص، تازگی به تنهایی کافی نیست. ارتباط همچنان بیشترین بار را به دوش می کشد.
صفحه جدیدی که با پرسش های فرعی خوب تطبیق داشته باشد استناد می شود. صفحه جدیدی که نداشته باشد بازیابی می شود، اما نادیده گرفته می شود.
همچنین باید توجه کرد که مجموعه صفحه های استناد نشده (حدود ۳ میلیون) در ref_type جستجو بسیار کوچک تر از گروه استناد شده (حدود ۲۳ میلیون) است. این موضوع اطمینانِ تفسیر شکاف سنی را محدود می کند.
تازگی در چه حوزه ای بیشترین اهمیت را دارد؟
تازگی بیشترین اهمیت را در «news» دارد.
در این دسته، امتیاز ارتباط عنوان برای صفحه های استناد شده و استناد نشده تقریباً یکسان است:
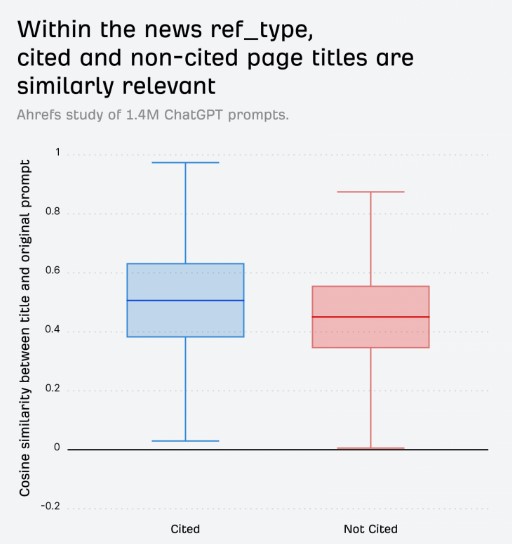
هوش مصنوعی نمی تواند فقط بر اساس ارتباط تصمیم بگیرد، پس به یک معیار تعیین کننده زمانی یعنی سن صفحه روی می آورد. صفحه های خبری استناد شده جوان ترند.
برای پرسش های خبری، صفحه های جوان تر برتری روشنی دارند، حتی وقتی امتیاز ارتباط بین استناد شده ها و استناد نشده ها مشابه است.
همه این ها برای «قابل استناد بودن» چه معنایی دارد؟
۱.۴ میلیون پرامپت تصویر نسبتاً روشنی نشان می دهند. ChatGPT یک ویراستار سخت گیر است. ایندکس جستجوی عمومی خودش را ترجیح می دهد، برای انتخاب و استناد منابع از شباهت معنایی استفاده می کند و با Reddit مثل کتاب درسی ای رفتار می کند که خجالت می کشد اعتراف کند خوانده است.
اما این داده ها یک درس احتیاط تحلیلی هم به ما دادند.
مقایسه های کلی بین URLهای «استناد شده» و «استناد نشده» می تواند گمراه کننده باشد، اگر مجموعه استناد نشده ها را یک نوع منبع با سازوکار بازیابی مخصوص خودش تحت سلطه گرفته باشد.
چیزی که ابتدا پارادوکس به نظر می رسید، یعنی استناد بیشتر به صفحه های کمتر بهینه شده، در واقع مسئله ترکیب مجموعه داده بود.
اگر بر اساس ref_type جدا نمی کردیم، در این یکی کاملاً اشتباه می کردیم.
در نهایت، صفحه هایی استناد می شوند که عنوان و محتوایشان با سؤال هایی که ChatGPT پشت صحنه می پرسد هم خوان است و از کانال بازیابی درست ظاهر می شوند.
منبع : Why ChatGPT Cites One Page Over Another (Study of 1.4M Prompts)
آدرس کوتاه این پست: https://backlinkiran.com/?p=18934