سیستم SAFE گوگل روشی برای بررسی سوءاستفاده های گسترده از محتوای مصنوعی است که طبق مقاله پژوهشی معرفی شده، محتوا، رفتار حساب ها و ارتباط میان کانال ها را کنار هم تحلیل می کند. این سیستم لزوما به معنای جریمه شدن همه محتواهای تولیدشده با هوش مصنوعی نیست؛ جزئیات عملکرد و ارتباط آن با به روزرسانی های اسپم گوگل نیز باید با احتیاط تفسیر شود.
گوگل چگونه با اسپم تولیدشده با هوش مصنوعی مقابله می کند؟
در گزارش منبع، از یک مقاله پژوهشی درباره روشی برای شناسایی اسپم صحبت شده است؛ روشی که تلاش می کند تخلفاتی را پیدا کند که شاید با هیچ قانون شناخته شده ای تطابق دقیق نداشته باشند، اما با هدف و روح دستورالعمل های یک پلتفرم در تضاد باشند.
نام این سامانه Scaled Abuse Forensics Examiner (SAFE) است؛ نامی که می توان آن را به صورت توصیفی «سامانه بررسی کارشناسی سوءاستفاده در مقیاس گسترده» ترجمه کرد. طبق توضیحات مقاله، تمرکز آن تنها بر تشخیص متن تولیدشده با هوش مصنوعی نیست.
SAFE ظاهرا نشانه های مختلفی را کنار هم قرار می دهد: محتوای منتشرشده، رفتار حساب ها، ارتباط میان کانال ها، زیرساخت های مشترک و اطلاعات چندرسانه ای. چنین رویکردی می تواند به بررسی شبکه هایی کمک کند که با تولید و انتشار انبوه محتوا سعی دارند از روش های سنتی شناسایی اسپم عبور کنند.
مقاله پژوهشی SAFE چه اطلاعاتی ارائه می دهد و چه چیزهایی نامشخص است؟
مقاله ای که در گزارش به آن استناد شده، کوتاه است و جزئیات فنی و نتایج عددی زیادی ارائه نمی کند. بنابراین، بهتر است توضیحات منتشرشده را از اطلاعاتی که هنوز در دسترس نیست جدا کنیم؛ از جمله میزان دقت سیستم، نرخ خطا، حجم داده های بررسی شده و نحوه اثرگذاری آن بر رتبه بندی جست وجو.
در مقاله به بررسی سوءاستفاده از ویدیوها و کانال های مصنوعی اشاره شده است. بخش تحلیل محتوا نیز از بردارهای معنایی چندوجهی (Multimodal Semantic Embeddings) نام می برد. این عبارت به نمایش های عددی از معنا و ویژگی های داده اشاره دارد که می توانند به مدل کمک کنند ارتباط میان متن، تصویر، ویدیو و انواع دیگر داده را بررسی کند.
«چندوجهی» یعنی تحلیل فقط به یک نوع ورودی محدود نیست. با این حال، وجود این اصطلاح در مقاله به تنهایی مشخص نمی کند که سیستم در همه موقعیت ها چه داده هایی را دریافت می کند یا هر نوع محتوا را با چه دقتی تحلیل می کند.
مقاله همچنین به الگوهای تعامل غیرطبیعی اشاره دارد؛ الگوهایی که ممکن است در شبکه های رباتی یا کمپین های هماهنگ برای دستکاری سامانه ها دیده شوند. در چنین شرایطی، بررسی یک محتوا به تنهایی کافی نیست و ارتباط آن با سایر حساب ها و فعالیت ها نیز می تواند مهم باشد.
گسترش شبکه های رباتی و کمپین های هماهنگ و خصمانه، به روش های قدرتمندی برای شناسایی الگوهای تعامل غیرانسانی نیاز دارد.
اگرچه بخش هایی از مقاله بر ویدیو تمرکز دارند، اصطلاحاتی مانند «رسانه مصنوعی»، «محتوای مصنوعی» و «سیگنال های چندوجهی» نیز در آن مطرح شده اند. بنابراین، بر اساس متن موجود نمی توان SAFE را صرفا سامانه ای برای تشخیص ویدیو دانست؛ در عین حال، نباید دامنه عملکرد آن را فراتر از شواهد منتشرشده فرض کرد.
SAFE چه ارتباطی با اسپم هوش مصنوعی و به روزرسانی های گوگل دارد؟
طبق گزارش منبع، SAFE دومین سامانه ای است که در سال ۲۰۲۶ برای شناسایی اسپم مرتبط با هوش مصنوعی معرفی شده است. سامانه دیگری با نام Scalable Cluster Termination System (S-CTS) نیز پیش تر مطرح شده بود.
ابزارهای هوش مصنوعی می توانند تولید حجم بالایی از محتوا را آسان کنند. شبکه های متخلف ممکن است متن، تصویر یا ویدیو را در مقیاس گسترده منتشر کنند و با تغییرات ظاهری، شناسایی هر مورد را دشوارتر سازند. بررسی دستی ارتباط میان محتواها، حساب ها و زیرساخت ها زمان بر است و در مقیاس بسیار بزرگ به سختی پاسخ گو خواهد بود.
مقاله پژوهشی SAFE با عنوان زیر معرفی شده است:
The Synthetic Gap: Automating Forensic Investigation of “AI Slop” with the Scaled Abuse Forensics Examiner (SAFE)
ترجمه توصیفی عنوان: «شکاف محتوای مصنوعی: خودکارسازی بررسی کارشناسی محتوای بی کیفیت هوش مصنوعی با استفاده از SAFE».
در این عنوان، «شکاف محتوای مصنوعی» به فاصله زمانی میان پدیدار شدن روش تازه ای برای سوءاستفاده از هوش مصنوعی مولد و آماده شدن راهکار مقابله با آن اشاره دارد. مقاله می گوید فرایندهای سنتی که به تشخیص دستی الگوها و تحلیل فراداده متکی هستند، برای مدیریت چنین حجمی از محتوا مناسب نیستند.
برای مراجعه به منبع پژوهشی، نسخه PDF مقاله SAFE را ببینید.
SAFE چگونه تخلف از روح دستورالعمل ها را بررسی می کند؟
طبق توضیحات مقاله، SAFE برای شناسایی مواردی که با هدف سیاست ها و دستورالعمل ها مغایرت دارند، از یک مدل زبانی بزرگ (Large Language Model یا LLM) بهره می گیرد. در متن به روش یادگیری چندنمونه ای (Few-Shot Learning) نیز اشاره شده است.
در یادگیری چندنمونه ای، مدل با مشاهده تعداد محدودی مثال یا دستورالعمل، یاد می گیرد وظیفه مشخصی را انجام دهد. این روش با آموزش کامل و جداگانه مدل برای هر مورد تازه یکسان نیست؛ اما جزئیات دقیق پیاده سازی SAFE در متن موجود به اندازه ای نیست که بتوان درباره همه مراحل آن با قطعیت توضیح داد.
هدف اعلام شده، پیدا کردن محتوایی است که شاید با یک قانون یا الگوی شناخته شده تطابق دقیق نداشته باشد، اما همچنان با هدف اصلی سیاست های پلتفرم در تضاد باشد. یک دسته بندی کننده سنتی ممکن است فقط برای شناسایی موارد مشخصی تنظیم شده باشد؛ در مقابل، بررسی زمینه و معنای محتوا می تواند به ارزیابی موارد پیچیده تر کمک کند.
آیا سیستم SAFE در حال استفاده است؟
بر اساس متن پژوهشی نقل شده در گزارش، SAFE مستقر شده و نتایج اولیه آن به افزایش سرعت شناسایی تهدیدهای مصنوعی و کاهش زمان بررسی کارشناسی اشاره دارند. با این حال، مقاله ارقام دقیق مربوط به سرعت، دقت یا نرخ خطای سیستم را منتشر نمی کند.
نتایج اولیه استقرار نشان می دهد که SAFE شناسایی تهدیدهای مصنوعی جدید را سریع تر می کند و زمان بررسی کارشناسی را در مقایسه با فرایندهای متکی بر حضور انسان کاهش می دهد.
این عبارت باید به عنوان ادعای نقل شده از مقاله در نظر گرفته شود، نه نتیجه ای که مستقلا در اینجا راستی آزمایی شده باشد. بدون داده های عددی و روش ارزیابی روشن، نمی توان اندازه این بهبود یا عملکرد SAFE در شرایط مختلف را تعیین کرد.
اصطلاح حضور انسان در حلقه تصمیم گیری (Human-in-the-Loop) به فرایندی گفته می شود که در آن انسان در کنار سیستم خودکار، خروجی ها را بازبینی می کند یا در تصمیم نهایی نقش دارد. خودکارسازی ممکن است زمان بررسی را کاهش دهد، اما اطلاعات موجود برای نتیجه گیری درباره حذف کامل نقش انسان یا میزان استقلال سیستم کافی نیست.
سه پایه فنی سیستم SAFE چیست؟
بخش پیش زمینه مقاله سه محور اصلی را شرح می دهد: شناسایی رفتارهای غیرطبیعی و هماهنگ، خودکارسازی بررسی کارشناسی با عامل های تخصصی و تحلیل معنا و زمینه محتوا با مدل های مبتنی بر ترنسفورمر. ترکیب این بخش ها به جای اتکا به یک نشانه منفرد، تصویر گسترده تری از فعالیت مشکوک فراهم می کند.
۱. شناسایی رفتارهای غیرطبیعی و هماهنگ
در این رویکرد، زمان انتشار محتوا، افزایش ناگهانی فعالیت، زیرساخت های مشترک و شباهت رفتار چند کانال می توانند برای بررسی بیشتر در نظر گرفته شوند. برای مثال، انتشار تعداد زیادی ویدیو در فاصله زمانی کوتاه یا بارگذاری هم زمان محتوا در چند کانال ممکن است نشانه ای برای بررسی دقیق تر باشد.
با این حال، هیچ کدام از این نشانه ها به تنهایی اثبات نمی کند که یک حساب یا محتوا اسپم است. انتشار پرتعداد می تواند دلایل مشروع هم داشته باشد؛ تشخیص تخلف به زمینه و مجموعه شواهد وابسته است.
۲. خودکارسازی بررسی کارشناسی با عامل های هوش مصنوعی
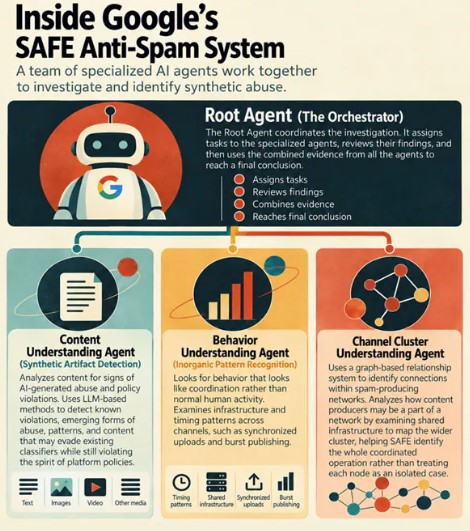
SAFE از عامل های تخصصی هوش مصنوعی (AI Agents) استفاده می کند تا بررسی را به چند وظیفه تقسیم کند. عامل هماهنگ کننده که در مقاله «عامل ریشه» (Root Agent) نامیده شده، کار سایر عامل ها را مدیریت می کند و یافته های آن ها را برای ارزیابی نهایی کنار هم می گذارد.
برای نمونه، یک عامل ممکن است بر محتوا تمرکز کند، عامل دیگری رفتار حساب ها را بررسی کند و عامل سوم ارتباط میان کانال ها را تحلیل کند. این نمونه توضیحی، تقسیم بندی کلی کارها را روشن می کند؛ اما نباید آن را شرح کامل و تاییدشده تمام جزئیات فنی سیستم دانست.
۳. تحلیل محتوا با مدل های مبتنی بر ترنسفورمر
مدل های مبتنی بر ترنسفورمر (Transformer-Based Models) برای تحلیل الگوها و ارتباطات موجود در داده به کار می روند. طبق گزارش، SAFE از چنین رویکردهایی برای بررسی معنا و زمینه محتوا استفاده می کند و به سیگنال های چندرسانه ای نیز توجه دارد.
تفاوت این رویکرد با جست وجوی ساده یک عبارت مشخص آن است که مفهوم محتوا و ارتباط آن با نشانه های دیگر هم بررسی می شود. با این وجود، مقاله منتشرشده جزئیات کافی برای تشریح معماری دقیق مدل یا نحوه وزن دهی به هر سیگنال ارائه نمی دهد.
چهار عامل تخصصی معرفی شده برای SAFE کدام اند؟
در گزارش، چهار عامل اصلی معرفی شده اند که هر کدام بخشی از فرایند تحلیل را بر عهده دارند:
- عامل ریشه یا هماهنگ کننده (Root Agent)
- عامل درک محتوا (Content Understanding Agent)
- عامل درک رفتار (Behavior Understanding Agent)
- عامل درک خوشه کانال ها (Channel Cluster Understanding Agent)
عامل ریشه؛ هماهنگ کننده فرایند
عامل ریشه وظیفه هماهنگی مراحل بررسی را دارد. این عامل وظایف را میان عامل های تخصصی تقسیم می کند، یافته های آن ها را کنار هم قرار می دهد و به شکل گیری ارزیابی نهایی کمک می کند. هدف این است که تصمیم تنها بر پایه یک نشانه منفرد گرفته نشود.
عامل درک محتوا؛ بررسی محتوای منتشرشده
این عامل محتوای منتشرشده را برای یافتن نشانه های سوءاستفاده و مغایرت با سیاست های پلتفرم بررسی می کند. طبق گزارش، مدل های زبانی بزرگ می توانند در ارزیابی تخلفات شناخته شده، روش های جدید سوءاستفاده و مواردی که از دسته بندی کننده های موجود عبور می کنند نقش داشته باشند.
بنابراین، مسئله صرفا این نیست که آیا محتوا با هوش مصنوعی تولید شده است یا نه؛ پرسش مهم تر این است که آیا محتوا در چارچوب یک الگوی سوءاستفاده یا رفتار ناقض سیاست ها منتشر می شود یا خیر.
عامل درک رفتار؛ یافتن الگوهای غیرعادی
این عامل رفتارهایی را بررسی می کند که ممکن است به فعالیت خودکار یا هماهنگ شباهت داشته باشند. زمان بندی انتشار، تکرار الگوها در چند کانال و فعالیت های هم زمان از جمله نمونه هایی هستند که می توانند در این تحلیل مورد توجه قرار گیرند.
این نشانه ها به تنهایی نتیجه قطعی به دست نمی دهند و باید در کنار اطلاعات دیگر ارزیابی شوند. رفتار پرتکرار یا زمان بندی منظم، بدون شواهد تکمیلی، لزوما به معنای اسپم نیست.
عامل درک خوشه کانال ها؛ بررسی ارتباط شبکه ای
عامل درک خوشه کانال ها از یک ساختار مبتنی بر گراف (Graph-Based System) برای بررسی ارتباط میان کانال ها و اعضای احتمالی یک شبکه استفاده می کند. در تحلیل گراف، موجودیت ها به صورت گره و ارتباط میان آن ها به صورت پیوند نمایش داده می شود.
این روش می تواند به بررسی ارتباط هایی مانند زیرساخت مشترک یا الگوهای مرتبط میان چند کانال کمک کند. در نتیجه، سامانه به جای بررسی کاملا جداگانه هر کانال، امکان ارزیابی یک الگوی هماهنگ در مقیاس بزرگ تر را دارد. این توضیح، توصیف کلی رویکرد مطرح شده در گزارش است و جزئیات داخلی پیاده سازی را مشخص نمی کند.
سیستم SAFE چه معنایی برای سئو و تولید محتوا دارد؟
مهم ترین نکته برای متخصصان سئو این است که مسئله اسپم را نباید فقط به ظاهر متن یا تشخیص ماشینی بودن آن محدود کرد. طبق شرح مقاله، SAFE علاوه بر محتوا، رفتار حساب ها، ارتباط میان کانال ها و زیرساخت های مشترک را نیز در نظر می گیرد.
به همین دلیل، بازنویسی سطحی متن تولیدشده با هوش مصنوعی یا تغییر چند واژه برای شبیه کردن آن به نوشته انسانی، تضمینی برای جلوگیری از شناسایی رفتار اسپم نیست. اگر انتشار محتوا بخشی از یک الگوی فریبکارانه یا شبکه هماهنگ باشد، تغییر ظاهری متن به تنهایی مشکل اصلی را حل نمی کند.
در عین حال، مقاله نشان نمی دهد که هر محتوای تولیدشده با هوش مصنوعی به خودی خود تخلف محسوب می شود. باید میان استفاده از ابزار هوش مصنوعی برای کمک به تولید محتوای مفید و استفاده از آن برای تولید انبوه محتوای کم ارزش یا دستکاری نتایج تفاوت گذاشت.
برای مدیران سایت، رویکرد عملی این است که بر نیاز واقعی مخاطب، دقت اطلاعات، ارزش افزوده، تجربه مستقیم و ویرایش انسانی تمرکز کنند. همچنین باید از تولید انبوه صفحات مشابه، انتشار فریبکارانه و ایجاد شبکه های مصنوعی برای دستکاری سامانه ها دوری کرد.
در نهایت، اطلاعات عمومی درباره SAFE هنوز برای نتیجه گیری قطعی درباره اثر مستقیم آن بر رتبه بندی کافی نیست. گزارش از هدف و برخی اجزای سیستم می گوید، اما ارقام عملکرد، نرخ خطا و جزئیات کامل استقرار را در اختیار خواننده قرار نمی دهد.
منبع : Google Has Deployed A New AI Spam Detector Called SAFE
آدرس کوتاه این پست: https://backlinkiran.com/?p=18881